
Published September 2026 by Qeekoo AI Story Lab
阿里巴巴前总参谋长曾鸣教授关于 AI 产业史观的论断,在行业内引发了极大的反响。作为一位完整经历过互联网周期的战略研究者,他将 AI 产业划分为三个阶段——基础设施成熟阶段、智能体应用爆发阶段、原生应用落地阶段。
他判断2026年是第一阶段基本完成的标志性节点,Token 成为通用度量衡,AI 成为社会的通用基础设施;第二阶段,智能体的大爆发,其序幕在2025年已经开启。至于第三阶段,要再等8到10年,才会出现抖音、拼多多级别的 AI 原生应用。
这个框架对从业者而言,犹如 AI 混沌时代的灯塔,为未来指明了路标。然而,作为深耕 AI 内容产业的实践者,当我们试图将这套理论框架落地到“故事创作”这个具体的垂直场景时,却发现了其缺失和需要补全的部分。
商榷一:三阶段论 VS 四层金字塔模型
曾鸣教授的观点
曾鸣教授说:“做智能体的公司其实没必要再开发大模型了。”
既然大模型已经成为水电一样的基础设施,Agent 公司可以低成本稳定调用,那就没有必要重复造轮子,应将核心技术放在应用创新上。
我们的商榷
我们认同曾鸣教授的观点,Agent 作为 LLM 通用能力的封装和分享,能够解决大部分问题。这个逻辑在“一次性任务”的场景中完全成立,写一篇文章、做一份 PPT、生成一张图片,调用 API 就够了。
但我们不完全认同“没必要再开发大模型”,也不认为通用 LLM 能够解决垂直领域的深度需求——即便在 LLM 进一步发展之后。所以,我们想要商榷的是,应用公司是否真的可以只停留在 Agent 和应用层?在 LLM 和应用层之间,是否还存在一个不可忽视的专业模型层?
在内容领域的深水区,即长篇小说和互动叙事,根本不是一个“一次性任务”,而是一个持续演化的生态系统。一部《三体》体量的长篇叙事,涉及数百个人物,跨越漫长的时间线,交织数十条因果链。当你写到第三部的结局时,第一部第三章某个配角的名字、性格、口癖,都必须保持严格一致——否则读者瞬间就会 OOC(Out Of Character,俗称“出戏”)。
面对这样的需求,仅仅在应用层调用 API 是无法解决的,因为 LLM 存在一个我们称之为“智能熵增”的结构性缺陷——随着任务周期延长、状态数量增加、因果关系复杂化,通用模型维持全局一致性的难度会持续增加。
具体表现在三个方面:
第一,上下文窗口是“滑动遗忘”。再大的窗口也是短期工作记忆,一旦填满,早期信息就会被挤出。AI 会不断遗忘自己之前设定的角色细节。
第二,概率生成缺少“规则约束”。LLM 的核心机制是概率生成,而复杂领域的一致性要求往往是确定性的、状态性的。它可能在第三章写“主角左眼有疤”,到第十章因为概率漂移变成“主角右眼有疤”,这并不是概率高低的问题,而是规则约束的缺失。
第三,没有内建的“长期审计机制”。大模型不会在生成新内容时,自动回去校验是否与十八章前的某个设定矛盾,这需要额外的状态管理与验证机制。
曾鸣教授所说的“上下文管理”和“记忆机制”,本质上相当于在应用层给大模型贴“外挂便签纸”。这对于短任务够用,但对于长叙事,“便签纸”就明显不够用了,因为问题不再是记住更多信息,而是如何定义、更新、验证整个系统的状态。
所以,我们被迫下沉,在 LLM 之上,构建一套“故事状态事务处理系统”,也就是我们所说的故事引擎(Story Engine)。它包含了角色状态追踪、伏笔管理、事件索引、因果逻辑审计等多个专用模块,这不是 Prompt 工程或 RAG 方案,而是为了对抗大模型天生的“智能熵增”,专门为“叙事一致性”和“长期状态维护”而设计的系统层。
这一层,我们称之为“专业模型层”,用来解决特定领域的复杂任务,把“通用智能”转化为更高效的“领域智能”。在 AI4S(AI for Science)领域,专业模型层的必要性和有效性已经得到了验证,如 Google DeepMind 用于蛋白质结构预测的 AlphaFold、微软用于材料设计的 MatterGen 等。
所以,相对曾鸣教授的“三阶段论”,我们更愿意用四层金字塔模型来描述 AI 的产业生态:基础设施层 → 基础能力层(LLM) → 专业模型层(故事引擎等) → 应用层。(具体参见我们之前的文章《大语言模型之后,下一个 AI 基础模型可能是什么?》)
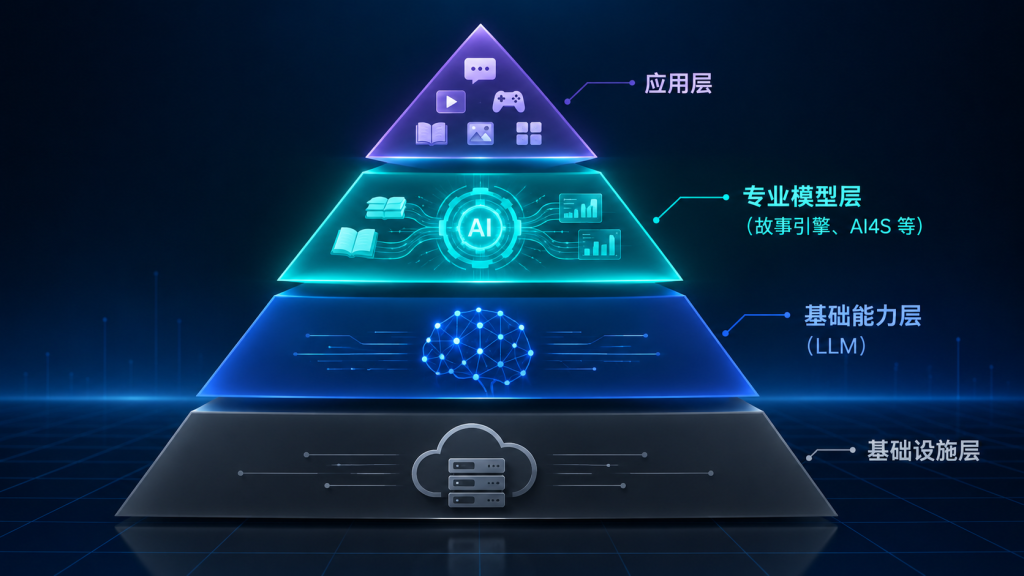
未来的 AI 生态,同样不是“一层通吃”,而是“底层通用、中层专用,上层繁荣、多层共荣”。就像电力革命给各行各业带来了繁荣,但发电厂这个基础设施至今没有被淘汰,而且依然是个好生意。
在内容产业这个细分领域,如果把通用大模型比作“电”,那故事引擎就是“电机”——没有电机,电只能点亮灯泡;有了电机,电才能驱动洗衣机、空调、机床,乃至整个现代工业。
商榷二:什么是真正的“AI原生”?
曾鸣教授的观点
曾鸣教授多次提及“AI 原生”的概念,并将其定义为与传统模式有根本差异的新形态,如 AI 原生组织、AI 原生应用等。他提出未来组织的最小单元将从“岗位”转变为“认知节点”,组织将围绕 AI 工作流来设计。
我们的商榷
“AI 原生”这个词,已经有点被滥用了。随便一个产品,只要加了一个 AI 聊天窗口,就敢自称 AI 原生应用。随便一个公司,只要员工用上了 AI,就敢自称 AI 原生组织。
在没有明确界限的时候,我们可以设定一个判断标准:如果去掉 AI,这个产品的核心价值是否仍然成立?
根据这个标准,我们可以把 AI 产品分为三个层级。这三个层级并非严格的递进关系,而是三种不同程度的产品变化。
其一是 AI 增强 —— 在原有产品上增加 AI 能力,AI 起到锦上添花的作用。例如微软 Office 深度集成了 Copilot,微信中增加了“小微”,百度搜索结果优先显示 AI 内容,这些产品因 AI 而变强,但即便去掉了 AI,也不会影响其核心价值。
其二是 AI 重构 —— 产品的核心工作方式已经被 AI 改变。例如语音输入法,过去很多年都是鸡肋产品,直到底层技术 AI 化之后,识别准确率大大提升,这才迈过了实用门槛,“鸡肋”直接变“鸡腿”,成了各大 LLM 的战略入口和数据富矿,就连微信都在桌面版中做了功能内置。
其三是 AI 原生 —— AI 创造了新的产品形态,如果没有 AI,这东西压根造不出来。互动小说是一个绝佳的案例。一部拥有数百章节、海量分支、因果严密的互动叙事作品,人类作家完全没有能力手动维护。是 AI 让这件事第一次具备了工程上的可行性,是 AI 催生了这个新物种。打开「奇酷互动小说」 APP,你会发现,AI 不是辅助,而是不可或缺的存在。
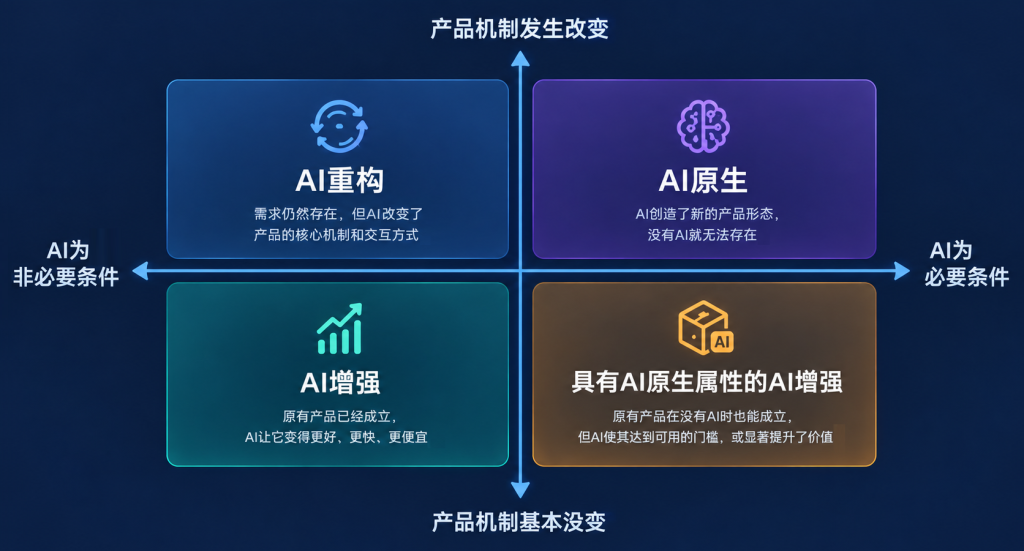
曾鸣教授用“根本差异”来定义 AI 原生,这个说法算不上错,但它过于宽泛、抽象,无法用来判断某个具体应用是否真的“原生”。而“没有 AI 就不可能存在”这个标准,清晰、具体、严苛,天然排除了那些“AI 套壳”产品。只有用这样的标准去筛选,才能找到下一个时代的真正创新者。
小结
曾鸣教授是我非常敬重的战略专家,他的《智能商业》常驻我的案头,给我带来了很多启迪。他对 AI 行业的趋势判断没有错,他是“空军视角”,俯瞰整个战场,标定战略方位。我们是“陆军中的工兵”,进入具体的场景,排除每一颗地雷,铺设每一条管线。战略家画出地图,实践者发现地图上没有标注的暗礁。
正如曾鸣教授所说,“卓越一定来自反共识”。我们提出的“商榷”,本质上是对曾鸣教授理论的一次实地测试。把他的框架扔进内容产业最深的水域,不是为了挑战权威,而是为了查漏补缺,让理论更能指导实践。
深水区的问题,只能在深水区解决。我们选择做那个最苦最累的“中层基建工”。